Misma consola, mismos repositorios, mismos jobs, otro hipervisor: Veeam 13.1 llega a OpenShift Virtualization 🤓

Veeam 13.1 puede respaldar las VMs de OpenShift Virtualization desde la misma consola que tu equipo ya usa, sin instalar un agente dentro del guest. Te muestro la arquitectura en un solo diagrama: cinco componentes (dos de ellos nuevos) y los cinco pasos que sigue un job de backup entre ellos.

Diagrama de arquitectura: VBR Server, Veeam Plug-in for KubeVirt, Veeam KubeVirt Proxy, VKP Data Movers y Backup Repository

Los componentes

VBR Server: el que da las órdenes

  • Qué es: tu servidor de Veeam Backup & Replication de siempre, físico o virtual.
  • Qué hace: guarda la configuración, programa los jobs, asigna recursos y coordina cada backup y cada restore. Además funciona como backup proxy de uso general, así que puede mover datos hacia y desde los repositorios por su cuenta.
  • Dónde está en el diagrama: arriba a la izquierda, alimentando al plug-in.
  • Modelo mental: la torre de control. Decide qué y cuándo; no lee los discos de las VMs.

Veeam Plug-in for KubeVirt: el traductor

  • Qué es: la capa de integración entre VBR y todo lo que es OpenShift Virtualization.
  • Qué hace: permite que el servidor de backup se conecte a un clúster de OpenShift Virtualization y ejecute tareas de protección de datos y recuperación ante desastres sobre sus recursos.
  • Dónde está: todavía del lado de Veeam, pero es el componente que baja hasta el clúster (la flecha verde que entra al Veeam KubeVirt Proxy).
  • Modelo mental: un despachante bilingüe. VBR habla de «jobs y repositorios»; el clúster habla de «pods y PVCs». Acá es donde se hace la traducción.

Veeam KubeVirt Proxy: el residente dentro del clúster

  • Qué es: un contenedor efímero que vive en un pod dentro del clúster protegido.
  • Qué hace: procesa las cargas de backup cuando los datos se mueven hacia y desde los repositorios.
  • Reglas de juego: exactamente un proxy por clúster protegido. Si tenés tres clústeres, desplegás tres proxies, y un solo VBR se puede conectar a todos.
  • Dónde está: a la izquierda de la caja de OpenShift, conectado a KubeVirt (azul) y al plug-in (verde).
  • Modelo mental: el capataz de obra. Es la única presencia permanente de Veeam en tu clúster, y es el que contrata a los trabajadores que vienen a continuación.

VKP Data Mover: el trabajador temporal que hace el trabajo pesado

  • Qué es: un servicio en un pod que el proxy despliega temporalmente para un job.
  • Qué hace: en un backup, lee los datos de los discos de la VM protegida y los envía al repositorio; en un restore, lee del repositorio y escribe en el destino.
  • Dónde está: en el centro-derecha del diagrama, uno por cada VM que se procesa (Data Mover 1 → VM1, Data Mover 2 → VM2), cada uno conectado a los PVCs de su VM.
  • Modelo mental: contratistas que llegan para el turno y se van. Es el pod que tu equipo de plataforma va a ver aparecer y desaparecer durante la ventana de backup, y la razón por la que no hace falta un agente dentro del guest.

Backup Repository: donde todo termina

  • Qué es: el almacenamiento donde VBR guarda los backups de tus VMs de OpenShift Virtualization.
  • Qué hace: ser el destino. Nada exótico: es el mismo concepto de repositorio que ya usás.
  • Dónde está: arriba a la derecha, recibiendo las flechas verdes que salen directo de los data movers.
  • Modelo mental: el depósito. El mismo depósito que usás para los backups de vSphere y Hyper-V, y ese es justamente el punto.

Leer el diagrama como una línea de tiempo

Si seguís las flechas en orden, el dibujo deja de ser una topología y se convierte en una secuencia:

  1. VBR le pasa el job al plug-in.
  2. El plug-in se comunica con el proxy dentro del clúster.
  3. El proxy levanta un data mover por cada VM y apunta cada uno a los discos de esa VM a través de KubeVirt.
  4. Cada data mover envía los datos directo al repositorio.
  5. Cuando termina el job, los data movers desaparecen; el proxy se queda para la próxima.

Dos de esos pasos corren completamente dentro de OpenShift, cerca del storage. Esa es la decisión de diseño que vale la pena recordar: el servidor de backup orquesta, el clúster hace el camino de los datos.

Un saludo a todo el equipo de Veeam que lanzó este increíble plug-in 👏

Publicado originalmente en inglés en Veeam Community.
🧠 Mapeo de Redes de VMware — De vSphere a OpenShift Virtualization

Todo lo mostrado aquí está incluido en todas las suscripciones de OpenShift.

Al migrar desde VMware, una de las primeras dudas es cómo se trasladan los conceptos de red. Este post lo explica visualmente.

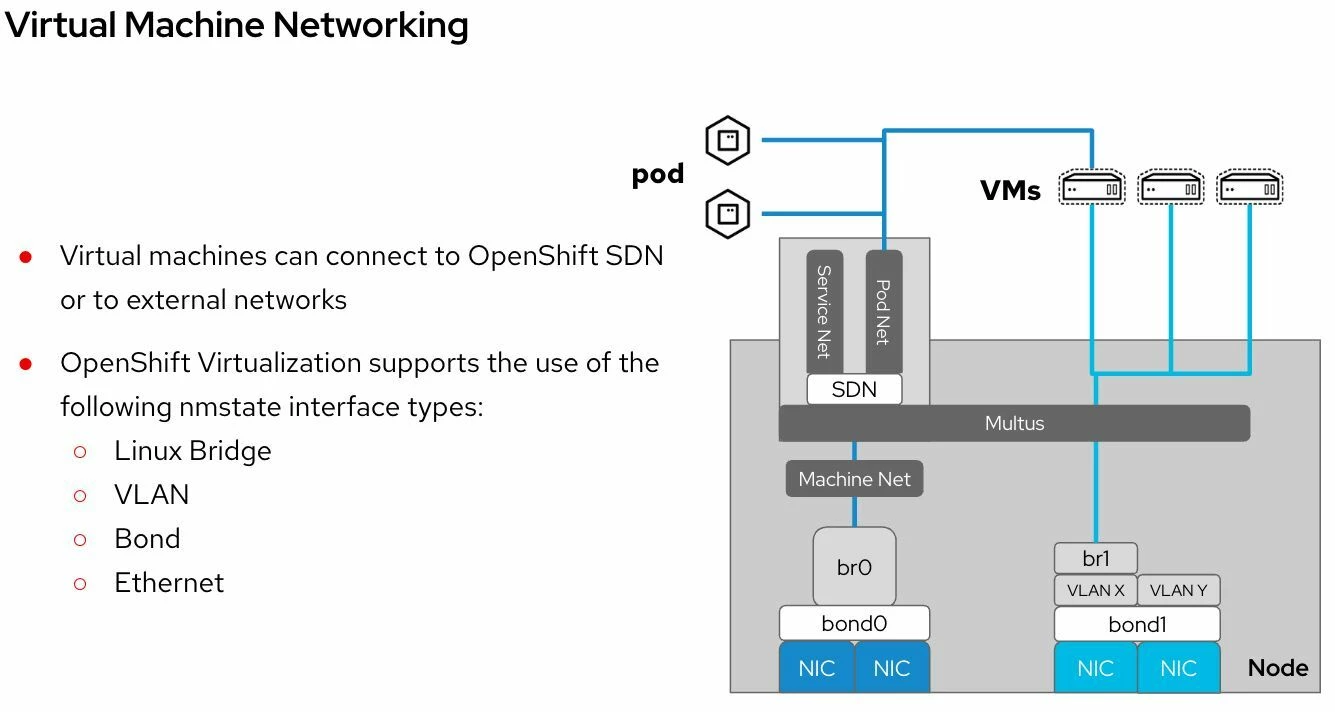
Figure 1: Virtual Machine Networking in OpenShift

Las VMs pueden conectarse a:

  • La SDN de OpenShift (red de pods/servicios)
  • Redes externas usando Multus + nmstate

Interfaces soportadas:

  • Linux Bridge
  • VLAN
  • Bond
  • Ethernet

Esto permite emular redes como las de VMware a nivel de nodo.

Figure 2: Core VMware to OpenShift Mapping

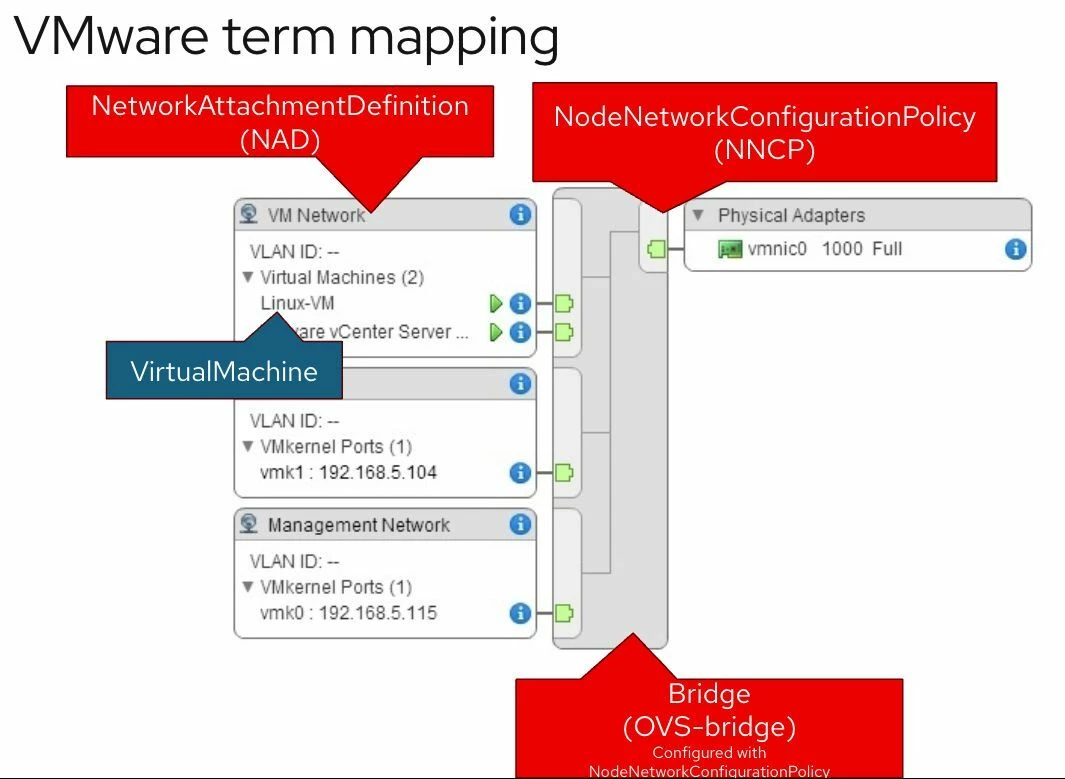
NIC física (vmnic) → Se configura con NodeNetworkConfigurationPolicy (NNCP)

VM Network → NetworkAttachmentDefinition (NAD)

Virtual Machine → Recurso VirtualMachine en OpenShift

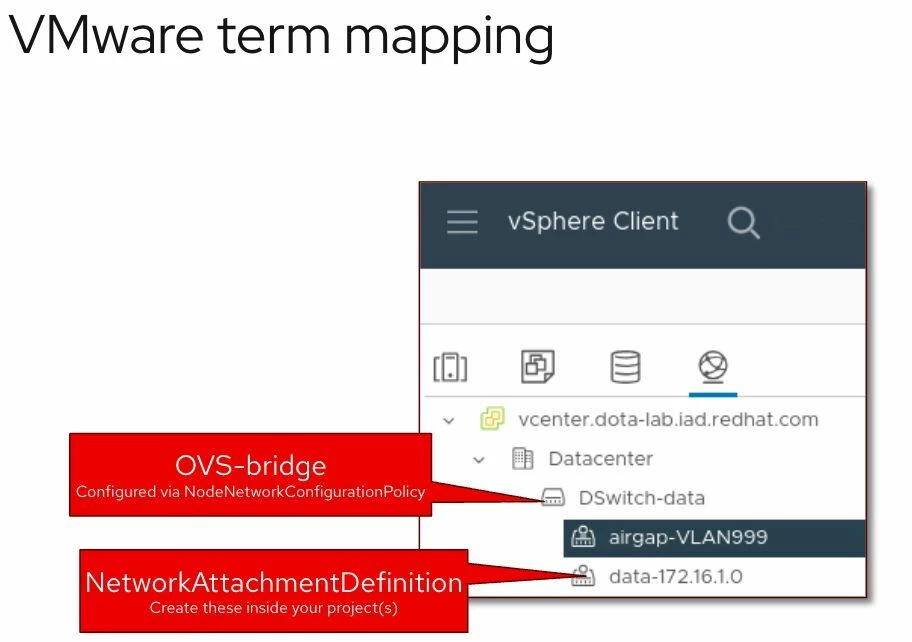
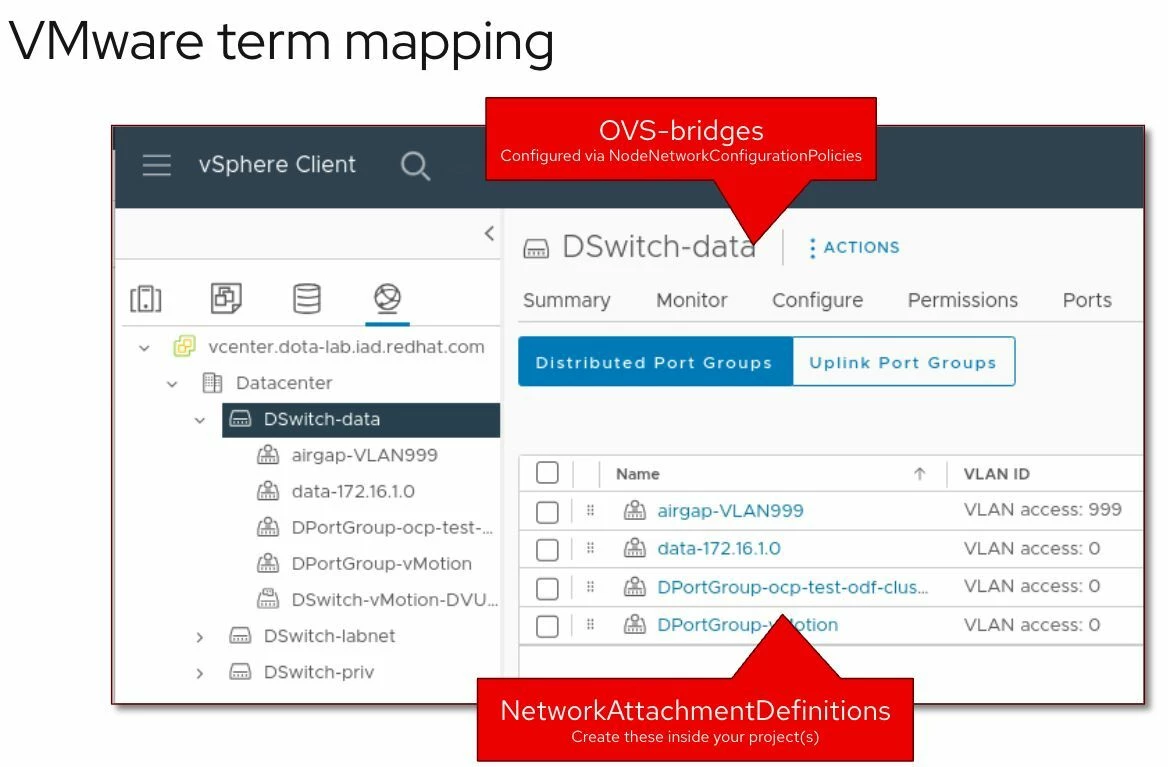
Figure 3 & 4: OVS-Bridges and NADs

  • OVS-bridges son equivalentes a port groups distribuidos.
  • Las NADs representan esos port groups dentro de un proyecto OpenShift.!

Ejemplo: airgap-VLAN999 es una NAD dentro del proyecto, conectada al bridge definido por NNCP.

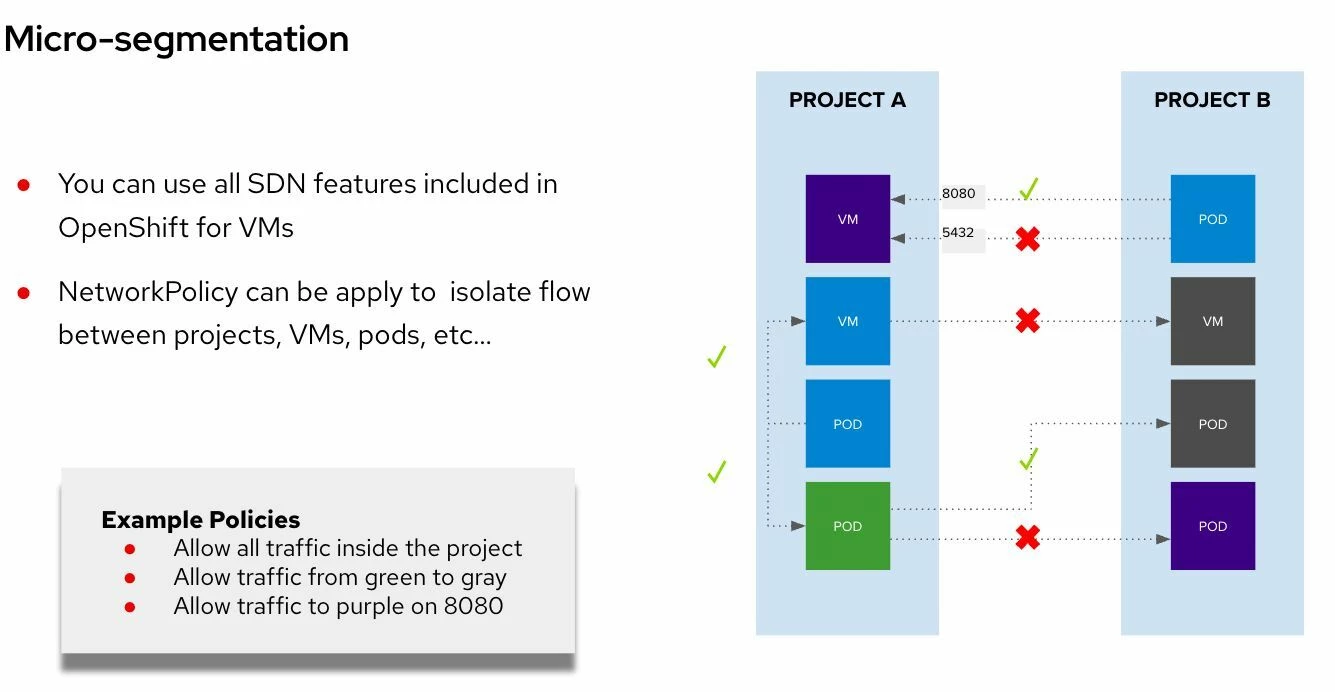
Figure 5: Micro-segmentation with OpenShift SDN

OpenShift supports NetworkPolicies to enable true micro-segmentation, even for VMs.

✅ Tu Puedes:

Gracias a las NetworkPolicies, OpenShift permite aislar tráfico:

  • Entre proyectos
  • Entre pods y VMs
  • Según puertos o etiquetas!

Ejemplos:

  • Permitir tráfico solo a la VM violeta en el puerto 8080
  • Bloquear tráfico del proyecto B al A
  • Permitir solo conexiones internas!

Todo esto también se aplica a VMs, sin costo adicional ni extensiones extra.

OpenShift permite crear una red virtualizada robusta y segura, compatible con prácticas de VMware — y todo está incluido con tu suscripción.

¿Cómo medir CPU Ready en OpenShift Virtualization? 🚀🤓

Todos los que administramos VMware sabemos de lo que hablamos cuando nombramos CPU Ready (%RDY) como Métrica de Rendimiento, entonces explicare que es, y como se mide en Openshift Virtualization.


¿Qué es CPU Ready?

El término “CPU Ready” puede dar lugar a malentendidos. Se podría pensar que representa la cantidad de CPU lista para ser usada y que un alto valor es algo positivo. Sin embargo, cuanto mayor sea el CPU Ready, peor será el rendimiento de la infraestructura vSphere y más sufrirán las aplicaciones.

Definición oficial de VMware:

Es el porcentaje de tiempo en que un «world» está listo para ejecutarse y esperando la aprobación del CPU Scheduler.

  • En vSphere, un «Ciclo» es un proceso.
  • Cuanto mayor sea el CPU Ready, más tiempo pasarán las VM sin ejecutar lo que deberían.

En otras palabras, un «Ciclo» es una vCPU esperando su turno para ejecutarse en un CPU físico. CPU Ready mide cuánto tiempo esa vCPU espera para ser programada y ejecutarse en un núcleo físico.

¿Qué causa un alto CPU Ready?

Identificar el alto uso de CPU es sencillo, pero encontrar la causa del CPU Ready puede ser más difícil. Las dos causas principales de un alto CPU Ready son:

  1. Alta sobreasignación de CPU (CPU Oversubscription)
  2. Uso de límites de CPU (CPU Limits)

Sobreasignación de CPU

  • La razón más común de CPU Ready alto es asignar más vCPUs de las que pueden ser manejadas por los CPU físicos.
  • Reglas generales para la relación vCPU:pCPU:
    • 1:1 a 1:3 → No hay problema.
    • 1:3 a 1:5 → Puede empezar a degradarse el rendimiento.
    • 1:5 o mayor → Probable problema de CPU Ready.

¿Cómo ver el CPU Ready en VMware?

  • La mejor manera de analizar CPU Ready es a nivel de VM y por vCPU, no a nivel de host.
  • En vSphere Client, en los gráficos de rendimiento, se puede agregar CPU Ready como métrica.
  • En esxtop, se puede ver el %RDY para cada VM.

¿Cuánto CPU Ready es “normal”?

  • VMware recomienda mantener CPU Ready por debajo del 5% por vCPU.
  • CPU Ready se mide en milisegundos (ms) en la UI de vSphere, pero para calcular el porcentaje real:
    • Si en 20 segundos (20000 ms) una VM tiene 2173 ms de CPU Ready, entonces: (2173 / 20000) = 10.87% → Esto es alto.

¿Cómo medir CPU Ready en OpenShift Virtualization?

En VMware vSphere, CPU Ready (%RDY) mide el tiempo que una vCPU pasa esperando ser programada en un CPU físico.
En OpenShift Virtualization, no existe una métrica llamada CPU Ready directamente, pero el equivalente en Kubernetes y OpenShift se mide a través del CPU Throttling.

📌 Métrica equivalente en OpenShift:

  • container_cpu_cfs_throttled_seconds_total
    • Mide el tiempo total (en segundos) que un contenedor (o VM en OpenShift Virtualization) ha estado «throttled», es decir, ha sido limitado en su uso de CPU porque excedió los recursos asignados.

📌 Otras métricas relacionadas:

  • container_cpu_cfs_periods_total
    • Cantidad total de períodos de CPU asignados al contenedor.
  • container_cpu_cfs_throttled_periods_total
    • Número de períodos de CPU en los que la VM fue restringida.
  • Usar Grafana en OpenShift Monitoring
    • Si tenés configurado Prometheus y Grafana, podés crear un dashboard con:
      • Métrica: container_cpu_cfs_throttled_seconds_total
      • Filtro: {pod=~"mi-vm-.*"} (para enfocarse en VMs específicas)
  • Usar oc adm top para obtener CPU en tiempo real
    • Comando:oc adm top pods -n mi-namespace
    • Esto muestra el uso de CPU y memoria en tiempo real para cada VM.

🚀 Recomendaciones para evitar CPU Throttling en OpenShift Virtualization

  1. No usar CPU Limits innecesarios
    • Si una VM tiene un CPU Limit bajo, puede ser constantemente restringida, causando CPU Throttling alto.
    • En su lugar, definir solo CPU Requests y dejar el Limit abierto si el host tiene recursos disponibles.
  2. Monitorear y ajustar los recursos asignados
    • Revisar periódicamente las métricas de CPU Throttling en Prometheus/Grafana.
    • Asegurar que las VMs críticas tengan suficientes recursos.
  3. Evitar la sobreasignación de vCPUs en los nodos físicos
    • En OpenShift, asignar más vCPUs de las que tiene el nodo físico puede causar contención y throttling.
    • Seguir ratios recomendados de vCPU vs. pCPU.

📊 Umbrales para interpretar CPU Throttling en OpenShift

CPU Throttling (%)EstadoImpacto en el rendimiento
0 – 5%🔵 ÓptimoNo hay impacto en el rendimiento.
5 – 10%🟡 AdvertenciaPosible latencia en aplicaciones sensibles a la CPU.
10 – 20%🟠 Problema moderadoPueden aparecer retrasos y degradación en el rendimiento.
> 20%🔴 CríticoLa VM o contenedor está fuertemente limitado, afectando su desempeño.

🛠️ Comparación rápida: VMware vs. OpenShift Virtualization

ConceptoVMware (vSphere)OpenShift Virtualization (KubeVirt)
CPU Ready (%)%RDY en esxtopcontainer_cpu_cfs_throttled_seconds_total
Medición en GUIvSphere ClientOpenShift Grafana Dashboard
Medición CLIesxtopoc adm top pods + Prometheus
Causa principalCPU OversubscriptionCPU Limits o sobrecarga del nodo